xAI ·
Grok 4.6 liderem CursorBench 3.2 – i to przy wyraźnie niższych kosztach
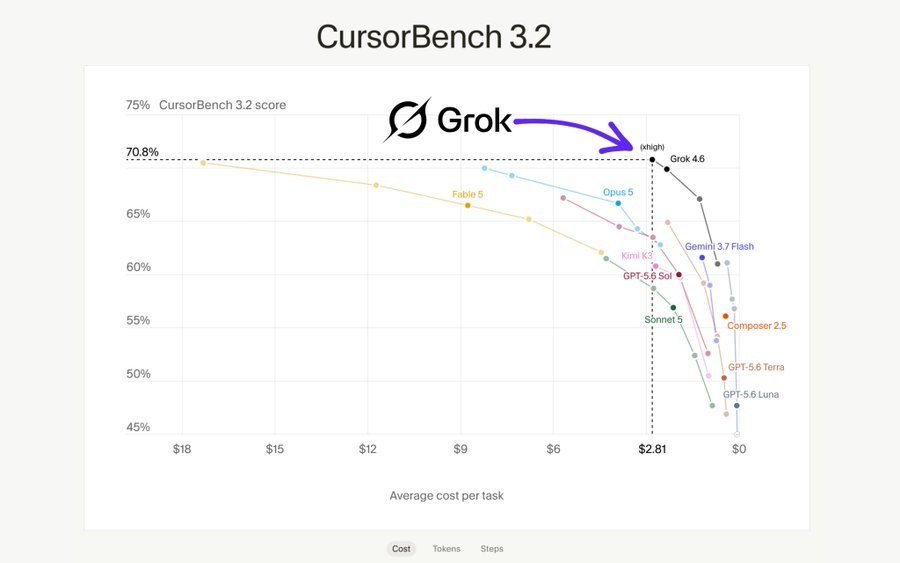
Grok 4.6 zajął pierwsze miejsce w najnowszej edycji CursorBench 3.2, benchmarku mierzącego skuteczność modeli w zadaniach agentowych (głównie kodowaniu).
Wyniki topowych modeli
- Grok 4.6 Extra High — 70,8% | 2,81 $ za zadanie
- Fable 5 Max — 70,5% | 17,32 $
- Opus 5 Max — 70,0% | 8,23 $
- GPT-5.6 Sol Max — 67,2% | 5,69 $
Grok osiągnął najwyższy wynik przy koszcie około sześciokrotnie niższym niż Fable 5 Max i niemal trzykrotnie niższym niż Opus 5 Max.
To właśnie ta kombinacja — topowa jakość przy wyraźnie lepszej efektywności kosztowej — jest w tym przypadku najważniejsza. W zastosowaniach agentowych, gdzie modele wykonują długie sekwencje zadań programistycznych, różnica w koszcie na zadanie szybko się kumuluje.
Wykres pokazuje wyraźnie, że Grok 4.6 wypada najlepiej pod względem stosunku wyniku do ceny. Przy podobnym lub wyższym poziomie skuteczności zużywa wyraźnie mniej zasobów.
Dla użytkowników budujących agentów kodujących to konkretna przewaga: model nie tylko dobrze radzi sobie z zadaniami, ale też pozwala dłużej pracować przy rozsądnych kosztach.
← Wszystkie wpisy